Ajouter un fournisseur et un modèle à son portail IA — 1. Le côté LiteLLM
Sommaire
Ce texte est notre to-do list, pas un tutoriel. On gère un portail IA auto-hébergé — Open WebUI pour l’interface, LiteLLM comme goulet unique vers les fournisseurs — et chaque fois qu’on ajoute un fournisseur ou un modèle, on déroule la même procédure. Elle est née des pièges qu’on a déverminés nous-mêmes : des paramètres avalés silencieusement, des modèles fantômes après suppression, des listes qui ne se rafraîchissent pas. On la publie telle quelle, telle qu’on l’exécute, avec le pourquoi de chaque geste. Elle est écrite pour notre stack, mais l’essentiel vaut pour toute installation Open WebUI + LiteLLM.
LiteLLM existe en deux modes : un fichier de configuration YAML, ou une base de données gérée via son dashboard. Cette procédure est écrite pour le mode base de données — c’est ce qu’on utilise. Les lecteurs en mode YAML trouveront un encart « Et en YAML ? » à chaque phase.
Prérequis : un portail Open WebUI + LiteLLM opérationnel, et une API key de fournisseur avec un plafond de dépense. Comment on obtient la clé et comment on pose le plafond côté fournisseur, ça dépend de chaque fournisseur — c’est hors périmètre ici. Le plafond, lui, n’est pas négociable : il est posé avant tout branchement. Précision pour les comptes prépayés type OpenRouter : le solde est déjà un plafond dur naturel ; la limite par clé, elle, vient en sous-plafond.
Exemple déroulé ici : OpenRouter, fournisseur passerelle multi-modèles.
La procédure rapide — côté LiteLLM #
Pour reprendre la procédure quand on la connaît déjà. Le pourquoi de chaque geste, les pièges et les diagnostics sont dans la version commentée ci-dessous.
- Créer le credential — Models & Endpoints → onglet LLM Credentials → + Add Credential : Credential Name, Display Name, Provider, API Key → Add Credential.
- Ajouter le modèle — + Add Model : Provider, Model (ID fournisseur complet, suffixe compris), Existing Credentials → Test Connect → Add Model seulement si le test passe.
- Vérifier la présence :
curl -s http://localhost:4000/v1/models \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" | jq -r '.data[].id'
- Tester le canal — une requête avec
max_tokens: 128: réponse tronquée nette = le canal transmet la famille standard de paramètres. - Tester chaque paramètre utile — valeur invalide :
curl -s http://localhost:4000/v1/chat/completions \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"<alias>","messages":[{"role":"user","content":"Réponds en un mot : ok"}],"<param>":"<valeur-invalide>"}'
Erreur du fournisseur = le paramètre traverse le schéma API ; réponse normale = droppé → diagnostiquer via /model/info avant de conclure. Dans les deux cas, l’effet reste à vérifier par runs — transmis ne veut pas encore dire pilotable.
- Ne mettre en dur dans
litellm_paramsque ce qui doit être garanti à 100 % — tout le reste se pilote côté utilisateur.
La procédure — version commentée #
L’article se coupe en deux parties, comme la stack : tout ce qui est en amont (fournisseur, modèle, params, vérification) vit côté LiteLLM — c’est cette partie-ci ; tout ce qui est en aval (visibilité, custom, usage) vit côté Open WebUI — c’est la partie 2.
Phase 1 — Déclarer le fournisseur #
Menu Models & Endpoints → onglet LLM Credentials → + Add Credential :
- Credential Name : identifiant technique (ex.
openrouter) — c’est lui qu’on référencera dans les modèles. - Display Name : étiquette affichée (ex.
Openrouter). - Provider : sélectionner le fournisseur (ex. Openrouter).
- API Key : la clé du fournisseur, masquée à la saisie, stockée chiffrée en base (salt LiteLLM) — jamais en clair dans un YAML.
- Add Credential pour valider. Le credential apparaît dans la liste de l’onglet.
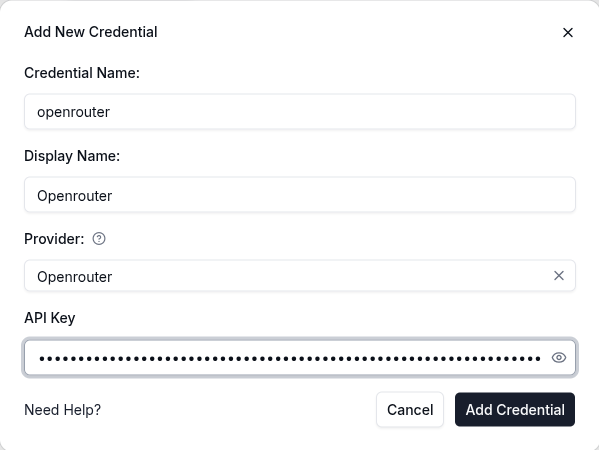
Pourquoi ça se passe ici : LiteLLM est le goulet unique entre Open WebUI et le fournisseur. La clé vit dans sa base, Open WebUI ne la voit jamais. À ce stade, LiteLLM sait parler au fournisseur, mais aucun modèle n’est encore exposé.
Et en YAML ? La clé se pose en api_key: os.environ/... dans le litellm_params du modèle — jamais en clair dans le fichier.
Phase 2 — Ajouter le modèle #
Menu Models & Endpoints → + Add Model :
- Provider : Openrouter.
- Model :
openrouter/nvidia/nemotron-3-ultra-550b-a55b:free— double préfixe :openrouter/(routage LiteLLM) + ID OpenRouter complet,:freecompris. Où trouver l’ID : catalogue openrouter.ai/models oucurl https://openrouter.ai/api/v1/models | jq '.data[].id'. - Existing Credentials : sélectionner le credential créé en phase 1 (pas de clé à retaper).
- Model Name : laisser l’auto-remplissage par défaut (l’alias qu’Open WebUI verra).
- Test Connect : vérifier que le modèle répond AVANT de l’enregistrer — si le test échoue, rien n’est cassé, on corrige et on reteste.
- Add Model seulement si le test est OK.
- Vérifier la présence — le geste de référence pour confirmer que le modèle est enregistré et vivant :
curl -s http://localhost:4000/v1/models \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" | jq -r '.data[].id'
Le modèle doit apparaître dans la liste — l’alias est l’ID complet (ex. nvidia/nemotron-3-ultra-550b-a55b:free). Ce listage est aussi le premier réflexe de diagnostic : si un modèle n’apparaît pas quelque part, on vérifie d’abord ici s’il est vivant côté LiteLLM avant de chercher plus loin.
Bonus : les modèles attachés à un credential nommé sont tracés dans la page Usage avec un tag Credential: <nom> — la conso se filtre par fournisseur sans config supplémentaire.
Et en YAML ? Le modèle est une entrée du model_list, mêmes champs.
Phase 3 — Les paramètres : doctrine GARANTIR / PILOTER #
Règle : un paramètre à GARANTIR à 100 % va en dur dans les litellm_params (LiteLLM) ; un paramètre à PILOTER à la main reste côté Open WebUI, c’est l’utilisateur qui porte la valeur.
Point de clarté à assumer : les paramètres et leurs valeurs varient selon le fournisseur et le modèle. L’article donne la méthode pour vérifier (page du modèle côté fournisseur + protocole de test), pas un tableau intemporel — un tableau serait périmé avant publication.
Le rôle de drop_params: true (global, posé dans le litellm_settings) : LiteLLM retire silencieusement tout paramètre non reconnu pour le modèle/fournisseur — c’est lui qui avale reasoning_effort sur un modèle sans raisonnement, sans erreur.
Pourquoi on le garde :
- C’est lui qui rend le portail tolérant : Open WebUI envoie systématiquement des paquets de params OpenAI (
frequency_penalty,logit_bias,user…) selon les réglages de l’utilisateur. Sans lui, chaque modèle qui n’en connaît pas un renverrait une 400 — l’utilisateur verrait des chats planter pour des réglages qu’il ne sait même pas envoyer. - C’est cohérent avec la doctrine : quand un paramètre utile est filtré à tort, le réflexe est de l’ajouter à
allowed_openai_params— ciblé, motivé par un test. Le désactiver globalement inverserait le fardeau : transmettre n’importe quoi à n’importe qui.
Le coût du choix est faible : un paramètre droppé se détecte par le test à valeur invalide, et on décide alors en connaissance de cause.
Test de transmission d’un paramètre (curl, depuis le serveur) #
curl -s http://localhost:4000/v1/chat/completions \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"<alias>","messages":[{"role":"user","content":"Réponds en un mot : ok"}],"reasoning_effort":"bidon"}'
Lecture en deux étapes — c’est le point le plus important de toute la procédure :
- Transmission : erreur du fournisseur = le paramètre traverse jusqu’au bout (le schéma API du fournisseur le connaît) ; réponse normale = paramètre droppé (LiteLLM
drop_params) ou avalé — creuser avant de conclure ; si le param doit passer mais est filtré →allowed_openai_params. - Effet : le schéma qui accepte ne prouve pas que le modèle gère le paramètre. Seul un test d’effet le prouve : plusieurs runs par niveau de réglage, en comparant ce que le modèle expose (bloc de réflexion, latence, longueur de réponse). Sans effet mesurable, le paramètre est transmis mais non pilotable en pratique.
Résultat de l’exemple (Nemotron 3 Ultra via OpenRouter) : le fournisseur refuse bidon en énumérant les valeurs valides :
max | xhigh | high | medium | low | minimal | none
{
  "object": "error",
  "message": {
    "detail": [
      {
        "type": "enum",
        "loc": ["body", "reasoning_effort"],
        "msg": "Input should be 'none', 'minimal', 'low', 'medium', 'high', 'xhigh' or 'max'",
        "input": "bidon"
      }
    ]
  },
  "type": "invalid_request_error"
}
Verdict : le paramètre traverse toute la chaîne, aucune config nécessaire — mais ça ne dit encore rien de son effet sur le modèle : c’est l’étape 2 qui tranche, et pour Nemotron elle est faite en partie 2 (effet prouvé : réponse fausse sans réflexion, juste avec). Leçon : la liste des valeurs valides vient du fournisseur lui-même, pas d’un tableau d’article.
Le piège du schéma : accepté ne veut pas dire géré (Mistral Large 4) #
Le cas inverse est arrivé le même jour, et il referme la boucle. Mistral Large 4 rejette bidon en énumérant ses sept valeurs — le paramètre traverse, le schéma le connaît. Mais en rejouant le même problème de maths aux sept niveaux, un run par niveau : aucun bloc de réflexion exposé, et une courbe de tokens non monotone (220 pour none, puis 724, 710, 805, 669, 653, 606 — ni progression ni régularité). Un seul run par niveau, donc pas de conclusion ferme — mais rien ne distingue les six niveaux actifs du bruit, tandis que le test d’effet de la partie 2 sur Nemotron montrait une différence radicale entre deux niveaux.
La leçon à retenir : le rejet du paramètre invalide prouve la transmission, jamais la gestion. Entre le schéma API du fournisseur (qui valide le param) et le modèle (qui peut l’ignorer), il y a un étage de plus qu’on ne voit pas en curl. Le verdict « pilotable » se mérite : transmission + effet vérifié par runs.
Contre-exemple : le paramètre avalé (Mistral Large 3, provider direct) #
Même curl, même valeur bidon → réponse normale, aucune erreur. Le paramètre a été avalé quelque part.
{
  "erreur": null,
  "contenu": "ok"
}
Diagnostic : curl /model/info filtré sur le modèle, deux choses à regarder dans model_info :
supported_openai_params: les params OpenAI que LiteLLM accepte de transmettre. Pour Mistral Large : pas dereasoning_effort→ c’est LiteLLM qui l’a droppé.supports_reasoning/reasoning_effort_levels:null→ le modèle n’expose aucun raisonnement pilotable.
Décision doctrine : on pourrait forcer le passage via allowed_openai_params, mais ça ne servirait à rien — le modèle ne supporte pas le paramètre. Rien à GARANTIR, on n’insiste pas.
Et la génération suivante a changé d’état : le même curl sur Mistral Large 4 est rejeté, avec énumération du vocabulaire. Même famille, même fournisseur, un slot de génération d’écart : la conclusion ne se transfère jamais d’un modèle à l’autre.
Troisième état : Mistral Small latest — même fournisseur, état différent #
Même curl → rejet 422, Mistral énumère son vocabulaire :
none | minimal | low | medium | high | xhigh | max
Le paramètre traverse — l’effet, lui, reste à vérifier par runs avant de le qualifier de pilotable.
Trois leçons :
- Deux modèles du même fournisseur peuvent être dans des états opposés. On ne vérifie jamais « par fournisseur », on vérifie par modèle.
- Le vocabulaire évolue : sept niveaux aujourd’hui, deux à l’époque où on avait documenté ce modèle. La vérification à l’ajout est la seule méthode pérenne.
- La passerelle elle-même évolue : il y a peu, LiteLLM rejetait
reasoning_effortsur les Mistral non-Magistral, et le contournement étaitallowed_openai_params. Corrigé depuis — le même curl a changé de verdict sans qu’on touche à rien. Le test à l’ajout prime toujours sur la doc ou la mémoire. Etallowed_openai_paramsreste dans la boîte à outils : contournement quand un param est bloqué à tort, ça redeviendra vrai pour un autre fournisseur demain.
Leçon de structure : un paramètre a plusieurs états possibles — transmis, droppé parce que non supporté, ignoré. Le /model/info est l’outil de diagnostic central.
Et en YAML ? Les params se posent dans le litellm_params de l’entrée, et chaque modif du fichier demande un restart du conteneur LiteLLM. Même en mode DB, le YAML garde les litellm_settings globaux (drop_params notamment) — seul le model_list vit en base.
Phase 4 — Vérifier le fonctionnement : le protocole de test, généralisé à n’importe quel paramètre #
La méthode de la phase 3 n’est pas propre à reasoning_effort. Démonstration avec le prompt caching — le paramètre prompt_cache_key, qui permet au fournisseur de mettre en cache le préfixe commun d’une conversation (system prompt, historique) et de facturer sa relecture bien moins cher que sa réévaluation.
Pré-requis technique du test : un préfixe commun conséquent (un system prompt de plusieurs milliers de tokens), identique entre les appels — c’est lui qu’on cache. Un prompt_cache_key avec un message de 30 tokens ne prouve rien.
PAYLOAD=$(jq -n --arg p "$(for i in $(seq 200); do echo 'Le chemin de fer en Bourgogne relie Dijon a Beaune et dessert Nuits-Saint-Georges, Gevrey-Chambertin et Chenove avant de franchir le canal de Bourgogne.'; done)" \
  '{model:"<alias>",
    messages:[{role:"system",content:$p},{role:"user",content:"Raconte en deux phrases."}],
    prompt_cache_key:"test-cache",max_tokens:400}')
for i in 1 2 3; do
  curl -s http://localhost:4000/v1/chat/completions \
    -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
    -H "Content-Type: application/json" \
    -d "$PAYLOAD" \
    | jq '{erreur: .error.message, pt: .usage.prompt_tokens, ct: .usage.prompt_tokens_details.cached_tokens}'
done
Le payload est construit par jq : zéro risque d’échappement, aucune dépendance à un fichier du serveur. Lecture : dans le usage des appels 2 et 3, prompt_tokens_details.cached_tokens > 0 = le préfixe est lu dans le cache. Le premier appel écrit, les suivants lisent.
Les trois états du prompt caching, observés le même jour #
État 1 — le cache garanti. Sur mistral/zai-glm-5-3 (GLM 5.3 derrière l’API Mistral), dont la fiche /model/info déclare supports_prompt_caching: true : premier appel à 0, puis les suivants lisent ~99 % du préfixe (9152 tokens cachés sur 9220), à chaque run, stable. Le paramètre traverse sans aucune config.
{"pt": 9220, "ct": 0}
{"pt": 9220, "ct": 9152}
{"pt": 9220, "ct": 9152}
État 2 — le cache best-effort. Sur tensorx-glm-5.3-flash (même modèle de base, autre hébergeur, cache mutualisé), vingt itérations du même appel donnent la courbe suivante : 16 hits sur 20, et aucun état intermédiaire — chaque run lit soit 0 %, soit 100 % du préfixe (4800 tokens sur 4820). Signature d’un cache LRU partagé avec les autres clients de l’hébergeur : l’entrée y est, ou elle a été évincée.
run 01 : pt=4820 cached=0     (0%)
run 02 : pt=4820 cached=0     (0%)
run 03 : pt=4820 cached=4800 (100%)
run 04 : pt=4820 cached=0     (0%)
run 05 : pt=4820 cached=0     (0%)
run 06 : pt=4820 cached=4800 (100%)
... (hits consécutifs jusqu'au run 20)
run 20 : pt=4820 cached=4800 (100%)
La leçon : un cache best-effort ne se pilote pas, il se constate. Le taux de hit est une variable de choix d’hébergeur, pas un réglage — et c’est un critère de sélection au même titre que le prix du token.
État 3 — pas de cache. Sur Nemotron (notre fil conducteur), trois appels : cached_tokens: 0 en boucle, aucune erreur — le paramètre est avalé. La fiche /model/info est cohérente : supports_prompt_caching absent, prompt_cache_key absent des supported_openai_params.
{"pt": 2423, "ct": 0}
{"pt": 2423, "ct": 0}
{"pt": 2423, "ct": 0}
Le twist : la fiche peut mentir (dans les deux sens) #
Le modèle de l’état 2 (best-effort) a une fiche /model/info qui ne déclare aucun support de cache — comme Nemotron. Et pourtant le cache prend à 80 %. Inversement, une fiche déclarative ne garantit pas que le paramètre passe. Le registre LiteLLM est un diagnostic, pas un verdict : le test réel reste le seul juge, et ce jour-là il a déjoué la fiche dans les deux sens — pessimiste pour le best-effort, il aurait pu être optimiste ailleurs.
Le protocole de test complet, en résumé #
- Transmission du canal : Max Tokens à 128, question à réponse longue, réponse tronquée nette = le canal transmet la famille standard.
- Transmission du paramètre : valeur invalide pour le fournisseur (
bidon), erreur renvoyée = le paramètre traverse le schéma API. Attention : accepté par le schéma ne veut pas dire géré par le modèle. - Effet réel : plusieurs runs par niveau de réglage, ne jamais conclure sur un run isolé. C’est ce test — et lui seul — qui fait passer un paramètre de « transmis » à « pilotable ». Si la variance masque l’effet : le paramètre passe, mais l’effet n’est pas mesurable par ce biais — ce n’est pas cassé pour autant.
- Garantie finale : un paramètre à garantir à 100 % va en dur dans
litellm_params. La requête entrante peut toujours le surcharger.
La suite — visibilité du modèle côté Open WebUI, modèle custom, vérification du transfert de configuration, retrait propre — est dans la partie 2.